
La herramienta no basta, lo que vuelve confiable un proceso agéntico es cómo se gobierna el modelo y quién lo acompaña, y el mejor modelo del momento no alcanza para eso. Conoce cómo hacer un proceso confiable.

El 20 de octubre, en Orlando, Gartner presentó las diez tendencias tecnológicas estratégicas para 2027. Seis de ellas tocan directamente las tres capacidades de nuestro portafolio. Esta es nuestra lectura, con lo que contamos los equipos que hacemos el trabajo todos los días.
El 6 de octubre, el Banco Mundial. El 20, la CEPAL y el Centro Nacional de IA de Chile. Dos mediciones distintas llegaron a la misma conclusión: el cuello de botella no está en la herramienta, sino en la capacidad de las organizaciones para absorberla. Un concepto académico de 1990 ordena lo que hoy describen los números.
Más de 30.000 desarrolladores respondieron este año la encuesta de Stack Overflow: 83% usa IA en su trabajo y apenas 6,6% confía en ella para decisiones importantes. En nuestro webinar "Agentes en el ciclo de software: del código a la calidad con método" contamos cómo construimos en Q-Vision lo que cierra esa distancia, y aquí lo cruzamos con la investigación más reciente.
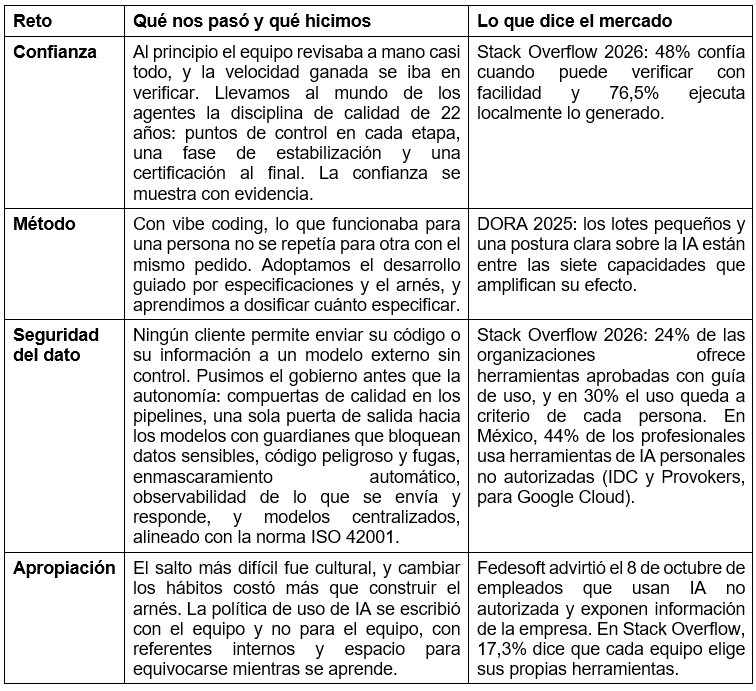
En el webinar, Verónica Bravo, nuestra líder de innovación, empezó con una imagen que cualquier equipo de tecnología reconoce: todo el mundo programa con IA y casi nadie queda tranquilo con lo que sale. Los datos recientes lo confirman. La encuesta de Stack Overflow, publicada el 6 de octubre, encontró que 83% usa al menos una herramienta de IA en el trabajo y que 73% de quienes usan asistentes o agentes de programación lo hace todos los días. Frente a eso, 48% dice que confía en el resultado solo cuando puede verificarlo con facilidad, y 6,6% confía lo suficiente como para usarlo en decisiones importantes. El informe DORA 2025 de Google Cloud, con casi 5.000 profesionales, había medido algo parecido: 90% usa IA en su trabajo y 30% confía poco o nada en el código que genera.
Lo que hacen los desarrolladores dice más que lo que responden. 76,5% ejecuta localmente lo que genera la IA, 63,9% lo compara con el código existente, 53% revisa las pruebas y las implicaciones de seguridad, y solo 9,6% lo usa tal cual. Verifican porque el resultado se ve bien, y eso es justamente lo que lo vuelve difícil de revisar.
Verónica contó cómo lo vivimos en casa. Construimos software todo el tiempo, para clientes y para nuestros propios productos, así que empezamos a trabajar con modelos de lenguaje apenas hubo acceso. Al principio hicimos lo que hizo casi todo el mundo: pedirle al modelo en lenguaje natural lo que queríamos, el llamado vibe coding. Para prototipar es una maravilla. Al llevarlo a aplicaciones productivas aparecieron los problemas. El código compilaba, hacía lo que habíamos pedido y por dentro fallaba: se equivocaba en los casos de borde, inventaba una función, llamaba a una librería que no existía o se olvidaba de validar un dato.
La frase que mejor lo resume es que el código de IA es plausible por construcción, pero no correcto por construcción. El modelo está entrenado para predecir lo más probable, y produce código que se parece al que suele verse en ese contexto. En ningún momento lo razona contra una especificación, lo ejecuta o lo prueba. La plausibilidad viene de fábrica. La corrección se construye con especificación, pruebas y validación.
Hay un segundo efecto que engaña a los equipos. En el experimento de METR de 2025, dieciséis desarrolladores expertos tardaron 19% más con herramientas de IA y, al terminar, creían haber sido 20% más rápidos. Por eso nuestro método mide el tiempo completo: escribir, revisar y corregir.
El desarrollo guiado por especificaciones no nació con la IA. Escribir qué debe hacer el sistema antes de construirlo es una idea vieja que volvió porque cambió la economía. Durante décadas lo caro y lento era teclear el código, y sentarse a especificar se sentía como un sobrecosto. Cuando un agente entrega una funcionalidad completa en minutos, el cuello de botella pasa a ser decidir con precisión qué construir. La especificación se volvió un contrato, y con un contrato claro el agente deja de improvisar y entrega algo que se puede verificar.
También aprendimos el límite. Especificar todo por adelantado devuelve al equipo a la metodología en cascada, lenta y rígida, justo lo que el agilismo vino a resolver. Dosificar cuánto especificar forma parte del método. DORA lo describe con otro nombre: entre las siete capacidades que, según su investigación, amplifican el efecto positivo de la IA están trabajar en lotes pequeños, tener una postura clara sobre el uso de la IA y darle a la IA acceso al contexto interno de la organización. El arnés: lo que rodea al modelo
Un agente es un modelo que corre herramientas en un bucle para cumplir un objetivo. El arnés es todo lo que rodea ese bucle: qué puede y qué no puede hacer el agente, qué necesita aprobación, qué hace cuando algo falla, las instrucciones del proyecto, las habilidades, las especificaciones y las barreras que vigilan lo que entra y lo que sale. El modelo piensa y el arnés decide qué puede hacer con ese pensamiento. En Q-Vision lo empaquetamos como forma de trabajar: el equipo llega al proyecto con el método montado y no inventa uno sobre la marcha. Cada desarrollador deja de usar el agente a su manera.
La palabra está de moda por una buena razón. El 20 de octubre, Gartner incluyó el arnés de agentes de programación entre sus diez tendencias estratégicas para 2027, y lo describe como un sistema de control en ciclo cerrado, con compuertas de verificación y ciclos de retroalimentación. Sin esa pieza, advierte, los desarrolladores terminan gastando su tiempo en verificar a mano lo que produce la máquina.
La investigación académica empieza a medir el efecto. En un estudio de agosto de 2026, Sydney Lewis dejó fijo el modelo y cambió una sola conducta del arnés: acortar los resultados antiguos de las herramientas a medida que se llena el contexto. Con una ventana ajustada de 20.480 tokens en 169 tareas, las soluciones completas pasaron de 43 a 72. Con ventanas amplias la diferencia fue pequeña. La conclusión de la autora es que el modelo y el arnés se evalúan juntos. El efecto depende de la tarea y del contexto, y por eso en cada proyecto lo medimos.
La norma ISO/IEC 42001, publicada en 2023, es el primer estándar certificable para sistemas de gestión de IA, y en Colombia las organizaciones pueden certificarse desde septiembre de 2025. Verónica lo resume con el orden que seguimos: primero el control y después la autonomía para delegar.
El recorrido de nuestra fábrica tiene cuatro momentos que cualquier equipo de software reconoce. Entra un requerimiento y sale software probado. Se entiende el contexto y se planifica, con la especificación convertida en tareas. Se desarrolla, se revisa y se optimiza el código. Se prueba con agentes de calidad que generan los casos de automatización, los ejecutan, miden la cobertura y detectan riesgos. Y se entrega, con la calidad validada, el despliegue preparado y una persona que da el visto bueno en los puntos críticos. Lo distinto es que en el camino actúan agentes, hasta trece en un mismo flujo, y las pruebas no quedan al final como un proceso aparte, porque cada mejora pasa por ellas.
Para el desarrollo hay un detalle técnico que nos costó resolver. Las ventanas de contexto son enormes y un solo agente sigue sin alcanzar a abarcar todo el proyecto. Orquestamos el trabajo con grafos: la tarea se divide en pasos que se pasan el contexto entre sí, con puntos de validación en medio. La encuesta de Stack Overflow ayuda a entender por qué. Solo 16% de los desarrolladores dice que la IA maneja muy bien las tareas complejas, y 39% la califica como buena, pero no excelente.
Lo que la encuesta también muestra es que la calidad no desaparece. 58% ya usa IA para escribir o mejorar pruebas, y 35% espera usarla más. Verónica fue escéptica desde el principio con la idea de que las pruebas dejarían de importar. Cuanto más código se genera, más hay que verificar. Lo que cambia es la forma: los agentes de calidad trabajan junto a las personas que gobiernan y validan.
¿Qué hacer cuando alguien se salta el método o usa herramientas que la compañía no contempló? Verónica respondió que sin gobierno no hay autonomía, y que prohibir una herramienta funciona menos de lo que parece. Lo que hicimos fue centralizar los agentes. La fábrica, con sus trece agentes, se comparte a nivel de organización: la compañía provee la licencia de la aplicación que definió, y quien recibe un requerimiento encuentra ya incorporado el arnés que define cómo se construye ese producto.
¿Cómo se valida que las recomendaciones de seguridad de un agente sean correctas? Con monitoreo constante de lo que entra y lo que sale. Hay herramientas que recolectan la telemetría y permiten ver las trazas de cada agente: qué recibió, qué validaciones hizo y qué decisiones tomó a partir de ellas. Se suma el gateway con guardianes, que valida antes de que una solicitud salga hacia un proveedor si esa información se puede enviar.
Si el mismo ecosistema de agentes planifica, programa y prueba, ¿Cómo se garantiza la independencia de la calidad? Es la pregunta más fina de la sesión. La respuesta de Verónica tiene dos partes. En una fábrica bien construida no hay un solo modelo que haga todo, y los agentes no comparten el mismo modelo de fondo. Además, los puntos de validación no tienen que ser agentes: pueden ser scripts y procesos determinísticos que evalúan las salidas sin inteligencia artificial, y cada agente lleva sus propias evaluaciones determinísticas. Un agente que se valida con otro puede terminar en un bucle de confianza mutua.
La investigación respalda la cautela. Un trabajo presentado en NeurIPS 2024 por Arjun Panickssery, Samuel Bowman y Shi Feng mostró que los modelos que evalúan texto reconocen sus propias generaciones y las prefieren. Un estudio de 2025 encontró que esa preferencia propia dañina persiste incluso cuando el evaluador se equivoca, y que los modelos más fuertes la muestran con más intensidad cuando fallan.
Debajo de la fábrica hay tres principios que funcionan en cualquier proyecto y con cualquier herramienta.
Definir responsabilidades. Trazar una línea clara entre lo que deciden los agentes en cada fase y lo que valida una persona. Sin esa línea el equipo cae en uno de los dos extremos: una persona revisa cada cosa y se pierde la velocidad, o el agente actúa sin control y se pierde la confianza. El agente se encarga del trabajo repetitivo y generativo, como escribir código, armar pruebas y documentar. La persona conserva las decisiones y la responsabilidad. En entornos regulados siempre tiene que haber alguien que responda, y esto debe quedar escrito en el arnés.
Poner puntos de control. Algunos son automáticos, como las pruebas, y un agente puede revisar a otro. Otros son humanos y obligatorios cuando el riesgo es alto: un despliegue, un cambio que toca datos sensibles, algo que no se puede deshacer. Un humano en cada paso mata la velocidad y ninguno mata la seguridad. Esa calibración es lo que vuelve auditable a una fábrica y evita que sea una caja negra.
Medir resultados. Calidad, con qué limpieza sale el trabajo y cuánto pasa los controles a la primera. Eficiencia, con cuánto tiempo y costo se ahorra de verdad. Confiabilidad, con qué consistencia funciona y cuántos incidentes deja. Importa si funciona y se sostiene en producción, y poco importa cuántas líneas generó el agente.
Medir bien tiene su método. Primero se fija una línea base: cuánto tardaba el equipo en hacer ese mismo ejercicio de la manera tradicional. Luego se mide el mismo ejercicio, con el mismo alcance, con el método agéntico. La cuenta incluye el tiempo de revisar y de corregir, que es donde el tiempo suele engañar, y el resultado final se mira en producción. Con ese método, en los ejercicios de innovación de la compañía registramos una reducción de 60% en el tiempo. Es una cifra interna, con línea base y alcance definidos, y no una promesa de resultado para cualquier equipo.
En Colombia, la encuesta de Cenisoft y Fedesoft divulgada el 7 de octubre mostró por qué la medición pesa: el desarrollo de software es el principal uso de los agentes de IA entre las empresas tecnológicas, con 74%, y 30,77% todavía no ha medido el impacto.
Con el método montado, la compañía sostiene un portafolio más amplio. No todos los productos nacieron con agentes: varios existen desde hace tiempo y los evolucionamos mucho más rápido. Hoy ofrecemos pruebas agénticas sin código, apoyo a la documentación y la estimación de proyectos, generación de datos sintéticos de prueba, gestión de riesgos frente a distintas normas y un conector que centraliza pasarelas de pago. Ninguno es una herramienta aislada, porque el método los sostiene.
En el esquema de nuestro portafolio esto se ve en tres lugares: Agentic SW Development, donde vive la fábrica; Quality Intelligence, donde se prueba lo que se construye; y Autonomous Data Stack, que alimenta las pruebas con datos que no exponen a nadie. Alrededor de todo está la frase que rige el diseño: Human in the loop.
Verónica cerró el webinar con la idea que queremos que se quede: la herramienta no basta. Lo que vuelve confiable un proceso agéntico es cómo se gobierna el modelo y quién lo acompaña, y el mejor modelo del momento no alcanza para eso. Esa es la ingeniería de este momento.
Puedes configurar tu navegador para aceptar o rechazar cookies en cualquier momento. Si decides bloquear las cookies de Google Analytics, la recopilación de datos de navegación se verá limitada. Más información.